Vektör veritabanı neden ortaya çıktı?
Geleneksel veritabanları, yapılandırılmış bilgileri saklamak ve belirli koşullara göre sorgulamak konusunda son derece etkilidir. Bir müşteriyi kimlik numarasıyla bulmak, belirli tarihte oluşturulan siparişleri listelemek veya fiyatı belirli bir değerin üzerindeki ürünleri getirmek için SQL ve klasik indeksleme yöntemleri yeterlidir.
Ancak kullanıcı şöyle bir soru sorduğunda problem değişir:
"İade süresi geçen fakat ürününde üretim hatası bulunan müşteriler için uyguladığımız prosedür nedir?"
Kurumsal dokümanda bu cümlenin birebir karşılığı bulunmayabilir. İlgili bölüm "Garanti kapsamındaki kusurlu ürün başvuruları" başlığı altında yer alabilir.
Burada yalnızca kelime eşleşmesi yapmak yeterli olmayabilir. Sistemin sorgu ile doküman arasındaki anlamsal benzerliği değerlendirmesi gerekir.
Vektör veritabanlarının temel kullanım alanlarından biri tam olarak budur.
Vektör arama altyapısı, metin, görsel veya başka türdeki verilerin makine öğrenmesi modelleri tarafından oluşturulan sayısal temsillerini saklamak, indekslemek ve benzerlik üzerinden aramak için kullanılan üst kavramdır. Bu yetenek bağımsız bir vektör veritabanı, ilişkisel veritabanı eklentisi, arama motoru veya yönetilen retrieval hizmetiyle sağlanabilir.
Bu sayısal temsillere embedding denir. OpenAI'nin güncel dokümantasyonunda embedding, metin dizileri arasındaki ilişkileri temsil eden kayan noktalı sayılardan oluşan bir vektör olarak tanımlanır. Vektörler arasındaki mesafe veya benzerlik, içeriklerin anlamsal olarak birbirine ne kadar yakın olduğunun hesaplanmasında kullanılabilir [1].
Bu mekanizma, Retrieval-Augmented Generation yani RAG sistemlerinin en yaygın retrieval altyapılarından biridir.
Embedding nedir?
Embedding modelinin görevi bir içeriği belirli boyutta sayısal bir uzaya dönüştürmektir.
Basitleştirilmiş olarak:
"Çalışan yıllık izin politikası"
        ↓
Embedding modeli
        ↓
[0.018, -0.072, 0.143, ..., 0.026]
Ortaya çıkan sayı dizisi insan açısından anlamlı değildir. Önemli olan, modelin anlamsal olarak ilişkili içerikleri vektör uzayında birbirine yakın konumlandırmaya çalışmasıdır.
Örneğin:
"Personelin yıllık izin hakkı nedir?"
ile
"Çalışanların yıllık izin süreleri"
kelime düzeyinde tamamen aynı değildir. Buna rağmen iyi bir embedding modeli bu iki metnin anlamsal olarak ilişkili olduğunu temsil edebilir.
OpenAI dokümantasyonuna göre embedding'ler arama dışında kümeleme, öneri sistemleri, sınıflandırma ve anomali tespiti gibi işlemlerde de kullanılabilir [1].
Bu nedenle vektör veritabanı yalnızca "LLM veritabanı" değildir. RAG, vektör aramanın önemli kullanım alanlarından yalnızca biridir.
Embedding üretmek, kaynak metnin anonimleştiğini veya kişisel veri niteliğini otomatik olarak kaybettiğini kanıtlamaz. Bir vektör tek başına insana anlamlı görünmese bile kaynak içerikle ilişkilendirilebilir ve benzerlik sorgularında kullanılabilir. Bu nedenle kişisel veri niteliği, anonimlik ve güvenlik değerlendirmesi dönüşümün adına değil; somut bağlamda kişiyi belirlenebilir kılma veya veriyle yeniden ilişki kurma olasılığına, kullanım amacına, erişimlere ve sistemin bütünü içindeki tedbirlere göre yapılmalıdır [9][10].
Vektör arama nasıl çalışır?
Tipik süreç dört temel adımdan oluşur.
1. İçerik embedding'e dönüştürülür
Önce aranacak içerikler embedding modeli kullanılarak vektörlere çevrilir.
Uzun dokümanlar çoğunlukla tek parça olarak saklanmaz. Doküman önce daha küçük chunk'lara bölünür.
Örneğin:
İK Politikaları.pdf
│
├── Chunk 1 → Çalışma saatleri
├── Chunk 2 → Yıllık izin
├── Chunk 3 → Hastalık izni
└── Chunk 4 → İşten ayrılma prosedürü
Her chunk için embedding oluşturulur.
2. Vektörler ve metadata saklanır
Bir kayıt yalnızca embedding'den oluşmak zorunda değildir.
Örneğin:
{
  "id": "doc_184_chunk_03",
  "vector": [0.12, -0.07, 0.31],
  "metadata": {
    "department": "human_resources",
    "document_id": "doc_184",
    "document_type": "policy",
    "version": "2026-03",
    "access_group": "employees"
  }
}
Qdrant terminolojisinde temel kayıt bir "point" olarak ifade edilir ve bir point, vektör ile isteğe bağlı payload bilgisini içerebilir [2].
Metadata'nın önemi özellikle kurumsal RAG uygulamalarında büyüktür. Çünkü retrieval yalnızca "hangi içerik benziyor?" sorusuyla sınırlandırılmayabilir.
Aynı zamanda:
- Kullanıcı bu dokümana erişebilir mi?
- Hangi departmana ait?
- Dokümanın geçerli versiyonu hangisi?
- Hangi ülkeye ait politika aranıyor?
- İçerik hangi ürün veya müşteriyle ilişkili?
gibi koşulların uygulanması gerekebilir.
3. Kullanıcının sorgusu embedding'e dönüştürülür
Kullanıcı:
"Yıllık izin hakkım kaç gün?"
diye sorduğunda sorgu, indeksleme sırasında kullanılan aynı embedding modeli, model sürümü ve boyutlandırma ayarlarıyla vektöre dönüştürülür. Farklı bir model ancak sağlayıcı modellerin açıkça ortak bir vektör uzayında uyumlu olduğunu belgeliyorsa kullanılmalıdır.
4. En yakın vektörler aranır
Sorgu vektörü ile veritabanındaki vektörler karşılaştırılır.
Sık kullanılan benzerlik veya mesafe yöntemleri arasında:
- cosine similarity,
- dot product,
- Euclidean distance
bulunur.
Örneğin Qdrant, cosine, dot product, Euclidean ve Manhattan ölçülerini desteklemektedir [3]. Kullanılacak metriğin embedding modelinin özellikleriyle uyumlu seçilmesi gerekir.
Sonuçta sistem kullanıcı sorgusuna en yakın içerik parçalarını döndürür.
RAG sisteminde vektör veritabanı nerede bulunur?
RAG, dil modelinin yanıt üretmeden önce harici bir bilgi kaynağından ilgili içerikleri bulmasını ve bunları modelin bağlamına eklemesini sağlayan bir mimari yaklaşımdır.
RAG kavramının yaygınlaşmasını sağlayan 2020 tarihli Lewis ve arkadaşlarının çalışması, parametrik model belleğini harici ve aranabilir bir non-parametric memory ile birleştiren bir yaklaşım ortaya koymuştur [4].
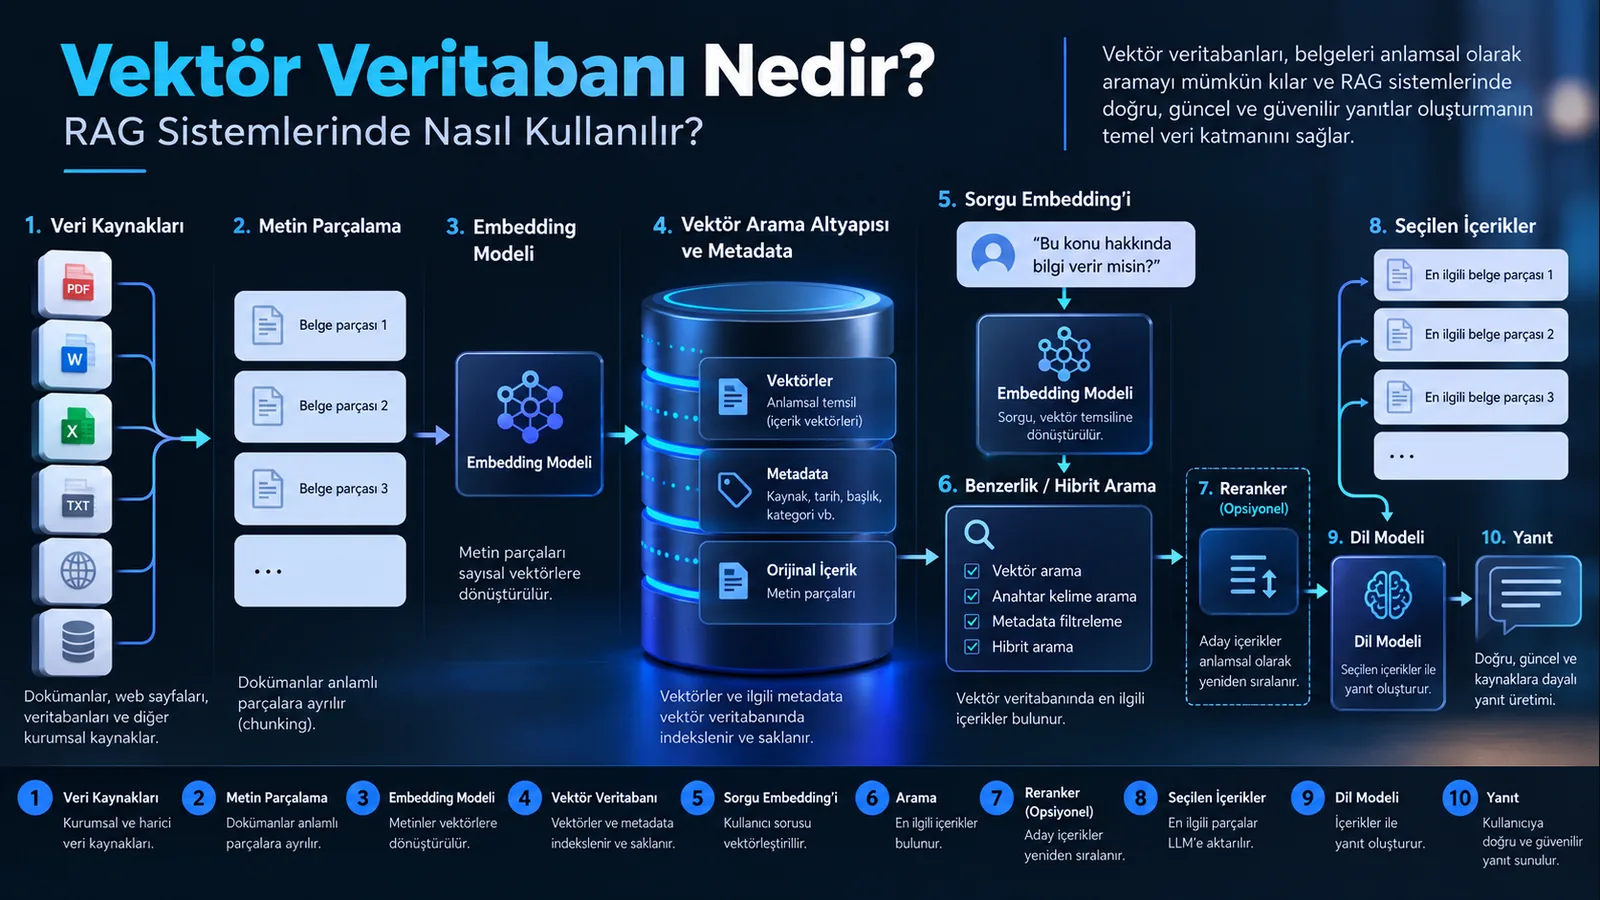
Günümüzde kurumsal RAG uygulamalarında temel akış çoğunlukla şöyledir:
Dokümanlar
    ↓
Metin çıkarma / temizleme
    ↓
Chunking
    ↓
Embedding modeli
    ↓
Vektör veritabanı
    ↓
-------------------------
Kullanıcı sorusu
    ↓
Query embedding
    ↓
Vector / hybrid search
    ↓
En ilgili chunk'lar
    ↓
Prompt / context oluşturma
    ↓
LLM
    ↓
Yanıt
Burada önemli bir ayrım vardır:
Vektör veritabanı yanıt üretmez.
Temel görevi ilgili bilgiyi bulmaktır. Yanıtı üreten bileşen genellikle büyük dil modelidir.
Bu nedenle bir RAG sistemindeki hataları yalnızca LLM performansına bağlamak yanıltıcıdır. Sistem yanlış dokümanları getiriyorsa güçlü bir model bile yanlış veya eksik bağlam üzerinden cevap oluşturabilir.
RAG için neden vektör veritabanı kullanılır?
Vektör aramanın en önemli avantajı, kelime eşleşmesinden bağımsız olarak anlamsal benzerlik üzerinden retrieval gerçekleştirebilmesidir.
OpenAI'nin Retrieval dokümantasyonu da semantic search'ün ortak anahtar kelime sayısı düşük veya sıfır olsa bile anlamsal olarak benzer sonuçları bulabilmesini temel özelliklerinden biri olarak açıklamaktadır [5].
Bu durum özellikle şu içeriklerde yararlı olabilir:
- şirket prosedürleri,
- teknik dokümantasyon,
- destek kayıtları,
- ürün katalogları,
- sözleşmeler,
- bilgi bankaları,
- kullanım kılavuzları,
- araştırma arşivleri.
Ancak bu avantaj, klasik aramanın gereksiz olduğu anlamına gelmez.
Semantic search, keyword search ve hybrid search
Kurumsal sistemlerde yalnızca semantic search kullanmak her sorgu türü için en iyi sonucu vermeyebilir.
| Yaklaşım | Güçlü olduğu alan | Zayıf olduğu alan |
|---|---|---|
| Keyword search | Ürün kodu, hata kodu, isim, model numarası, tam ifade | Eş anlamlı ve farklı biçimde ifade edilen sorgular |
| Vector search | Anlamsal benzerlik, doğal dil sorguları | Tam kod veya nadir anahtar kelimeler |
| Hybrid search | Anlamsal ve sözcüksel eşleşmeyi birlikte kullanma | Daha fazla indeksleme ve sorgu karmaşıklığı |
Örneğin kullanıcı:
ERR-8492
diye arıyorsa bunun anlamsal karşılığını bulmaya çalışmak yerine tam karakter dizisini aramak daha doğru olabilir.
Buna karşılık:
"Ödeme alındı ama sipariş oluşturulmadığında ne yapmalıyım?"
gibi bir sorguda semantic search daha yararlı olabilir.
Bu nedenle modern retrieval sistemlerinde dense ve sparse retrieval sonuçlarının birleştirildiği hybrid search mimarileri kullanılabilir. Qdrant dokümantasyonu da dense retrieval'ın anlamsal yakınlık, sparse retrieval'ın ise tam kelime ve identifier eşleşmeleri açısından farklı güçlü yönleri olduğunu belirtmektedir [6].
Exact search ve Approximate Nearest Neighbor arasındaki fark
Az sayıda vektör olduğunda sorgu vektörünü bütün kayıtlarla karşılaştırmak mümkündür. Bu yaklaşım exact nearest neighbor search olarak düşünülebilir.
Veri büyüdükçe her sorguda bütün vektörleri taramak maliyetli hale gelebilir.
Bu noktada Approximate Nearest Neighbor (ANN) indeksleri devreye girer.
Amaç, tüm vektörleri tek tek karşılaştırmak yerine en olası komşuların bulunduğu alanı hızlı biçimde taramaktır.
Yaygın yöntemlerden biri HNSW — Hierarchical Navigable Small World indeksidir.
PostgreSQL üzerinde vektör arama sağlayan pgvector hem HNSW hem IVFFlat indekslerini desteklemektedir. pgvector dokümantasyonuna göre HNSW genellikle IVFFlat'e kıyasla daha iyi sorgu performansı/recall dengesi sunarken indeks oluşturma süresi daha uzun olabilir ve daha fazla bellek kullanabilir. IVFFlat ise daha hızlı oluşturulabilir ve daha az bellek tüketebilir ancak sorgu performansı/recall dengesi farklıdır [7].
Buradaki kritik kavram recall'dır.
ANN araması performans kazanmak için bazı adayları hiç incelemeyebilir. Bu nedenle hız artarken gerçekten en yakın sonuçların ne kadarının bulunduğu ayrıca ölçülmelidir.
Metadata filtreleme neden önemlidir?
Kurumsal RAG sistemlerinde semantic similarity tek başına yeterli değildir.
Bir şirketin bilgi tabanında:
Türkiye
Almanya
Fransa
için farklı insan kaynakları politikaları bulunduğunu düşünelim.
Kullanıcı Türkiye çalışanıysa sorguya şu filtre uygulanabilir:
country = "TR"
Benzer şekilde:
department = "finance"
document_status = "active"
access_level <= user_access_level
gibi filtreler uygulanabilir.
Qdrant, vektör araması sırasında payload alanları üzerinden koşullar uygulanmasına ve bu alanlar için indeks oluşturulmasına izin vermektedir [8].
Metadata bu nedenle yalnızca açıklayıcı bilgi değildir. Doğru tasarlandığında retrieval kapsamını ve erişim kontrolünü yöneten temel katmanlardan biri olabilir.
Ancak uygulamanın güvenlik modeli yalnızca metadata filtrelerine bırakılmamalıdır. Yetkilendirme kontrolleri uygulama ve veri erişim katmanlarında ayrıca uygulanmalıdır.
Chunking stratejisi retrieval kalitesini nasıl etkiler?
RAG sistemlerinin en sık küçümsenen konularından biri chunking'dir.
Çok büyük chunk kullanılırsa retrieval sonucu alakalı bölümle birlikte çok miktarda gereksiz bilgi taşıyabilir.
Çok küçük chunk kullanılırsa anlam için gerekli bağlam parçalanabilir.
Örneğin:
Madde 14:
Çalışan aşağıdaki durumlarda uzaktan çalışma hakkından yararlanabilir...
ile devamındaki istisnalar farklı chunk'lara ayrılırsa sistem yalnızca ilk bölümü getirerek eksik bağlam sağlayabilir.
Bu nedenle chunk boyutu için evrensel bir sayı yoktur.
Karar verirken:
- doküman yapısı,
- paragraf ve başlık sınırları,
- kullanılan embedding modeli,
- sorgu tipi,
- LLM context kapasitesi,
- retrieval sonucu sayısı
birlikte değerlendirilmelidir.
Chunk overlap bazı senaryolarda sınırda kalan bilginin kaybolmasını azaltabilir ancak gereksiz tekrar, daha fazla embedding ve depolama maliyeti oluşturabilir.
Reranking nedir?
Vektör veritabanından ilk aşamada örneğin 30 sonuç alınabilir.
Bunların tamamını doğrudan LLM'e göndermek yerine ikinci bir model veya sıralama mekanizmasıyla adaylar yeniden puanlanıp sıralanabilir. Uygulama daha sonra bağlam penceresi, gecikme ve kalite hedeflerine göre üst sıralardaki belirli sayıda sonucu — örneğin 5 sonucu — LLM'e gönderebilir.
Aday kümesini yeniden puanlama ve sıralama süreci reranking olarak adlandırılır; sonuç sayısını azaltmak ise bunu izleyen isteğe bağlı bir seçim adımıdır. Microsoft'un Azure AI Search dokümantasyonunda semantic ranker, ilk sonuç kümesini ikincil bir sıralama aşamasında yeniden puanlayan bir özellik olarak açıklanır [12].
Örnek:
Sorgu
 ↓
Vector Search
 ↓
Top 30 aday
 ↓
Reranker
 ↓
Top 5
 ↓
LLM
Bu mimaride vector search hızlı biçimde aday kümesini daraltır; reranker ise daha pahalı fakat daha ayrıntılı bir değerlendirme yapabilir.
Dolayısıyla RAG performansını yalnızca embedding modelini değiştirerek iyileştirmeye çalışmak yerine retrieval pipeline'ının tamamını ölçmek gerekir.
Vektör veritabanı seçenekleri nasıl karşılaştırılmalı?
Piyasada farklı mimari yaklaşımlar vardır.
Örneğin:
- bağımsız vector database,
- PostgreSQL gibi mevcut veritabanına vector extension eklemek,
- yönetilen retrieval/vector store hizmeti kullanmak.
Bunların hiçbiri her proje için otomatik olarak doğru seçenek değildir.
| Kriter | Bağımsız Vector DB | PostgreSQL + Vector Extension | Yönetilen Retrieval |
|---|---|---|---|
| Operasyon kontrolü | Yüksek | Yüksek | Sağlayıcıya bağlı |
| Mevcut ilişkisel verilerle entegrasyon | Ek entegrasyon gerekebilir | Doğal avantaj | Servise bağlı |
| Vector search özellikleri | Genellikle kapsamlı | Eklentiye bağlı | Sağlayıcıya bağlı |
| Altyapı yönetimi | Self-hosted ise ekip gerekir | PostgreSQL operasyonu gerekir | Daha az olabilir |
| Özelleştirme | Yüksek | Yüksek | Servis sınırlarına bağlı |
| Başlangıç karmaşıklığı | Ürüne göre değişir | Mevcut PostgreSQL varsa düşük olabilir | Genellikle düşük |
| Vendor bağımlılığı | Seçime göre | Görece düşük olabilir | Daha yüksek olabilir |
Karar verirken yalnızca benchmark sonuçlarına bakmak yerine gerçek iş yükü üzerinde ölçüm yapılmalıdır.
Vektör veritabanı seçerken kontrol listesi
Aşağıdaki soruların yanıtları teknoloji seçiminden önce netleştirilmelidir:
- Kaç doküman ve tahmini kaç chunk saklanacak?
- Veri büyüme hızı ölçüldü mü?
- Sorgu başına kabul edilen gecikme süresi tanımlandı mı?
- Exact search mi ANN mi gerektiği test edildi mi?
- Metadata filtreleri belirlendi mi?
- Tenant veya müşteri izolasyonu gerekiyor mu?
- Hybrid search gerekli mi?
- Embedding modeli değiştirildiğinde re-index süreci planlandı mı?
- Silinen dokümanların embedding'lerinin de silindiği doğrulanıyor mu?
- Yetkilendirme retrieval aşamasında uygulanıyor mu?
- Backup ve disaster recovery gereksinimleri tanımlandı mı?
- Retrieval kalitesini ölçen test veri seti var mı?
- Maliyet; embedding, depolama, compute ve sorgu hacmiyle birlikte hesaplandı mı?
Kurumsal RAG için temsili senaryo
Aşağıdaki örnek gerçek bir şirket veya proje değildir; yöntemin nasıl uygulanabileceğini göstermek için hazırlanmış temsili bir senaryodur.
Bir üretim şirketinin aşağıdaki dokümanlara sahip olduğunu düşünelim:
- kalite prosedürleri,
- bakım kılavuzları,
- iş güvenliği dokümanları,
- teknik servis kayıtları,
- makine kullanım kılavuzları.
Amaç, bakım teknisyenlerinin doğal dille soru sorabileceği bir bilgi asistanı oluşturmaktır.
İlk aşamada dokümanlar merkezi bir veri pipeline'ına alınır.
Her belge için:
document_id
document_type
machine_model
department
revision
valid_from
access_level
metadata alanları oluşturulur.
Dokümanlar başlık ve bölüm yapıları dikkate alınarak chunk'lara ayrılır. Her chunk embedding modelinden geçirilerek vektör veritabanına kaydedilir.
Teknisyen:
"X200 pompasında basınç düştüğünde ilk kontrol edilmesi gereken parçalar neler?"
diye sorduğunda sistem sorgunun embedding'ini oluşturur.
Arama sırasında:
machine_model = "X200"
document_status = "active"
filtreleri uygulanır.
İlk retrieval sonucunda bulunan içerikler gerekiyorsa reranking işleminden geçirilir. Seçilen bölümler kaynak bilgileriyle birlikte LLM'e gönderilir.
Modelden ise yalnızca verilen kaynaklara dayanarak cevap oluşturması istenir.
Bu mimaride asıl başarı kriteri yalnızca cevabın akıcı olması değildir.
Önce şu soruya bakılmalıdır:
Doğru kaynak retrieval aşamasında gerçekten bulundu mu?
RAG sistemi nasıl ölçülmeli?
RAG değerlendirmesini en az iki katmana ayırmak yararlıdır.
Retrieval değerlendirmesi
Ölçülmesi gereken sorular:
- Beklenen doküman top-k sonuç içerisinde mi?
- Gereksiz dokümanlar ne sıklıkta geliyor?
- Metadata filtreleri doğru uygulanıyor mu?
- Hybrid search semantic search'e göre anlamlı iyileşme sağlıyor mu?
- ANN indeksinin recall kaybı kabul edilebilir seviyede mi?
Bunun için gerçek kullanıcı sorgularını temsil eden değerlendirme veri seti oluşturulabilir.
Generation değerlendirmesi
Retrieval doğruysa ikinci aşamada:
- Yanıt kaynaklara dayanıyor mu?
- Kaynakta bulunmayan iddialar ekleniyor mu?
- Cevap soruyu gerçekten karşılıyor mu?
- Kaynak referansları doğru mu?
- Belirsizlik gerektiğinde ifade ediliyor mu?
kontrol edilir.
Bu ayrım hata ayıklamayı kolaylaştırır.
Çünkü yanlış cevap şu üç durumdan kaynaklanabilir:
Doğru bilgi indekslenmedi
        ↓
Doğru bilgi indekslendi ama retrieval bulamadı
        ↓
Retrieval doğru bilgiyi buldu ama LLM yanlış kullandı
Bu üç problem farklı çözümler gerektirir.
Veri güvenliği ve kişisel veriler
Embedding'lerin sayısal vektörlere dönüştürülmesi, kaynak verinin güvenlik ve gizlilik gereksinimlerini ortadan kaldırmaz.
Kurumsal RAG sistemi kişisel veri içeren dokümanları indeksliyorsa veri yaşam döngüsü bütün olarak değerlendirilmelidir.
KVKK'nın yapay zekâ alanındaki tavsiyeleri; kişisel veri kullanılmadan aynı sonuca ulaşılabiliyorsa anonimleştirme gibi yöntemlerin değerlendirilmesini, veri minimizasyonunu ve veri sorumlusu/veri işleyen rollerinin projenin başında belirlenmesini önermektedir [9]. Kurumun üretken yapay zekâ rehberi de kişisel veri işleme faaliyetlerinin 6698 sayılı Kanun çerçevesinde değerlendirilmesi gerektiğini vurgulamaktadır [10].
Bu nedenle RAG projesinde en az şu sorular cevaplanmalıdır:
- Kaynak dokümanlarda kişisel veri bulunuyor mu?
- Bu verilerin işlenmesi için hukuki dayanak nedir?
- Hangi veri embedding servisine gönderiliyor?
- Servis sağlayıcının veri saklama ve işleme koşulları nedir?
- Vektör veritabanı hangi bölgede tutuluyor?
- Kullanıcı hangi dokümanlara erişebiliyor?
- Kaynak veri silindiğinde embedding ve türetilmiş kayıtlar da siliniyor mu?
- Loglarda sorgular veya hassas bilgiler tutuluyor mu?
Özellikle çok müşterili sistemlerde tenant izolasyonu tasarımın başında ele alınmalıdır.
pgvector dokümantasyonu da ortak approximate index kullanan çok kiracılı yapılarda tenant'ların birbirlerinin recall ve performansını etkileyebileceğine dikkat çekmekte; izolasyon için partition veya ayrı tablolar gibi seçenekler sunmaktadır [7].
Vektör veritabanı halüsinasyonu çözer mi?
Hayır.
Vektör veritabanı modelin daha ilgili kaynaklara erişmesini sağlayabilir ancak LLM'in yalnızca bu kaynaklara dayanarak cevap vereceğini garanti etmez.
RAG sisteminde hâlâ:
- yanlış retrieval,
- eksik retrieval,
- güncelliğini kaybetmiş doküman,
- çelişkili kaynaklar,
- yanlış chunking,
- prompt injection,
- yetkisiz veri erişimi,
- modelin kaynağı yanlış yorumlaması
gibi riskler bulunabilir.
NIST'in Generative AI Profile dokümanı üretken yapay zekâ risklerinin sistem yaşam döngüsü boyunca yönetişim, ölçüm ve risk azaltma mekanizmalarıyla ele alınmasını önermektedir [11].
Dolayısıyla "RAG kullanıyoruz, model artık yanlış cevap vermez" yaklaşımı teknik olarak güvenilir değildir.
Hangi durumlarda vektör veritabanı kullanılmamalı?
Her arama problemi semantic search problemi değildir.
Örneğin:
SELECT *
FROM invoices
WHERE invoice_number = 'INV-2026-9182';
gibi kesin eşleşme gerektiren bir işlem için vektör veritabanına ihtiyaç yoktur.
Benzer şekilde:
- kesin finansal hesaplamalar,
- transactional işlemler,
- ilişkisel bütünlük gerektiren kayıtlar,
- tam ID eşleşmeleri,
- deterministik filtreleme
gibi işlemlerde geleneksel veritabanı daha uygun olabilir.
Bir RAG sisteminde de her veriyi embedding'e dönüştürmek doğru değildir.
Yapılandırılmış ürün verileri SQL'de tutulurken uzun açıklamalar vector search üzerinden aranabilir. Gerçek dünyadaki mimariler çoğu zaman tek veritabanı yerine farklı veri erişim yöntemlerinin birlikte kullanıldığı hibrit yapılardır.
RAG projesine nasıl başlanmalı?
Teknoloji seçimiyle başlamak yerine retrieval problemi tanımlanmalıdır.
1. Kullanıcı sorgularını toplayın
Gerçek kullanıcıların sorabileceği 50–100 temsilî sorguyla başlanabilir.
Amaç, sistemin neyi bulması gerektiğini belirlemektir.
2. Beklenen kaynakları işaretleyin
Her sorgu için doğru doküman veya doküman bölümü belirlenir.
Böylece retrieval performansı ölçülebilir hale gelir.
3. Basit baseline oluşturun
Önce basit bir:
chunking
+
embedding
+
vector search
pipeline'ı kurulabilir.
4. Retrieval sonuçlarını ölçün
Top-k sonuçların doğru dokümanı içerip içermediği kontrol edilir.
5. Soruna göre geliştirme yapın
Gerekirse:
- chunking değiştirilebilir,
- metadata filtreleri eklenebilir,
- embedding modeli değiştirilebilir,
- hybrid search uygulanabilir,
- query rewriting kullanılabilir,
- reranker eklenebilir.
6. LLM'i daha sonra optimize edin
Retrieval katmanı güvenilir değilken yalnızca prompt veya LLM değiştirmek temel problemi gizleyebilir.
Maliyet hangi bileşenlerden oluşur?
Vektör veritabanının maliyeti yalnızca veritabanı lisansı veya bulut faturası değildir.
Toplam maliyet şu bileşenlerden oluşabilir:
Doküman işleme
+
Embedding oluşturma
+
Vector storage
+
Index memory
+
Query compute
+
Reranking
+
LLM token kullanımı
+
Monitoring
+
Backup
+
Operasyon
Embedding boyutu da önemlidir. Daha yüksek boyutlu vektörler genel olarak daha fazla depolama, bellek ve işlem kaynağı gerektirir. OpenAI'nin embedding dokümantasyonu da embedding boyutunun dimensions parametresiyle azaltılabildiğini ve bunun performans ile kaynak kullanımı arasında bir tercih oluşturabileceğini belirtmektedir [1].
Bu nedenle yalnızca "en büyük embedding modeli" yaklaşımı yerine gerçek veri üzerinde kalite/maliyet testi yapılmalıdır.
Üretime geçmeden önce son kontrol
Bir RAG sistemini üretime almadan önce şu soruların tamamına yanıt verilebilmelidir:
- Hangi veri kaynaklarının indekslendiği kayıt altında mı?
- Chunking stratejisi gerçek sorgularla test edildi mi?
- Retrieval değerlendirme veri seti oluşturuldu mu?
- Top-k retrieval başarısı ölçülüyor mu?
- Metadata filtreleri test edildi mi?
- Kullanıcı yetkileri retrieval'a uygulanıyor mu?
- Silinen veya güncellenen belgelerin indeksleri senkronize ediliyor mu?
- Embedding modeli ve sürümü kayıt altında mı?
- Prompt injection ve veri sızıntısı senaryoları test edildi mi?
- Kaynak gösterimi uygulanıyor mu?
- LLM cevap veremediğinde güvenli fallback davranışı tanımlandı mı?
- Maliyet ve gecikme için kabul kriterleri belirlendi mi?
- Retrieval ve generation ayrı ayrı izlenebiliyor mu?
Sonuç
Vektör veritabanı, RAG mimarisinin bilgi erişim katmanında önemli bir rol oynar. Embedding'leri saklayarak doğal dil sorgularıyla içerikler arasında anlamsal benzerlik kurulmasını sağlar.
Ancak başarılı bir RAG sistemi yalnızca vektör veritabanı kurmaktan ibaret değildir.
Verinin nasıl parçalandığı, embedding modelinin seçimi, metadata yapısı, vector index ayarları, hybrid search, reranking, erişim kontrolü ve retrieval değerlendirmesi birlikte ele alınmalıdır.
En kritik ayrım ise retrieval ile generation arasındadır: önce doğru bilginin bulunup bulunmadığını, ardından modelin bu bilgiyi doğru kullanıp kullanmadığını ölçmek gerekir.
Bu yaklaşım, RAG sistemini yalnızca çalışan bir demo olmaktan çıkarıp ölçülebilir ve yönetilebilir bir kurumsal bilgi erişim sistemine dönüştürmenin temelidir.
Sık Sorulan Sorular
Vektör veritabanı nedir?
Vektör veritabanı, embedding olarak ifade edilen yüksek boyutlu sayısal vektörleri saklamak, indekslemek ve benzerlik üzerinden aramak için kullanılan veri altyapısıdır. Semantic search ve RAG sistemlerinde yaygın olarak kullanılır.
RAG için vektör veritabanı şart mı?
Hayır. RAG bir retrieval yaklaşımıdır ve retrieval farklı yöntemlerle gerçekleştirilebilir. Küçük veri kümelerinde klasik arama, SQL, full-text search veya başka retrieval yöntemleri yeterli olabilir. Vektör veritabanı özellikle anlamsal arama gerektiğinde değerlidir.
Embedding ile vektör veritabanı arasındaki fark nedir?
Embedding, içeriğin sayısal temsilidir. Vektör veritabanı ise bu temsilleri saklayan, indeksleyen ve benzerlik sorguları gerçekleştiren altyapıdır.
Semantic search ile keyword search arasındaki fark nedir?
Keyword search kelime veya terim eşleşmesine ağırlık verir. Semantic search ise sorgu ve dokümanların embedding'leri arasındaki anlamsal yakınlığı kullanır. Hybrid search iki yaklaşımı birlikte kullanabilir.
HNSW nedir?
HNSW, büyük vektör koleksiyonlarında yakın komşuları hızlı biçimde bulmak için kullanılan Approximate Nearest Neighbor indeksleme yöntemlerinden biridir. Hız kazanımı karşılığında exact search'e göre farklı recall özelliklerine sahip olabilir.
RAG'de chunk boyutu kaç olmalı?
Her veri kümesi için geçerli tek bir ideal chunk boyutu yoktur. Doküman yapısı, embedding modeli, sorgular, bağlam gereksinimi ve retrieval performansı birlikte test edilmelidir.
Vektör veritabanı halüsinasyonu engeller mi?
Hayır. Doğru kaynakların modele ulaştırılmasına yardımcı olabilir ancak yanlış retrieval, eksik veri veya modelin kaynakları yanlış yorumlaması nedeniyle hatalı cevaplar yine oluşabilir.
Vektör veritabanında kişisel veri tutulabilir mi?
Teknik olarak içeriklerden üretilen embedding'ler saklanabilir; ancak kişisel veri içeren sistemlerde işleme amacı, hukuki dayanak, veri minimizasyonu, erişim kontrolü, saklama ve silme süreçleri ilgili veri koruma mevzuatına göre değerlendirilmelidir.
Kaynaklar
[1] OpenAI — "Vector embeddings" — erişim tarihi: 27 Eylül 2026
URL: https://developers.openai.com/api/docs/guides/embeddings
Desteklediği iddialar: Embedding tanımı, embedding kullanım alanları, cosine similarity, embedding boyutları ve boyut/maliyet ilişkisi.
[2] Qdrant — "Points" — erişim tarihi: 27 Eylül 2026
URL: https://qdrant.tech/documentation/concepts/points/
Desteklediği iddialar: Qdrant veri modelinde point yapısının vektör ve isteğe bağlı payload içermesi.
[3] Qdrant — "Collections" — erişim tarihi: 27 Eylül 2026
URL: https://qdrant.tech/documentation/manage-data/collections/
Desteklediği iddialar: Collection yapısı ve cosine, dot product, Euclidean ve Manhattan mesafe/benzerlik seçenekleri.
[4] Patrick Lewis ve diğerleri — "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" — 2020 — erişim tarihi: 27 Eylül 2026
URL: https://arxiv.org/abs/2005.11401
Desteklediği iddialar: RAG yaklaşımının parametrik model belleği ile harici non-parametric memory/retrieval bileşenini birleştiren temel mimarisi.
[5] OpenAI — "Retrieval" — erişim tarihi: 27 Eylül 2026
URL: https://developers.openai.com/api/docs/guides/retrieval
Desteklediği iddialar: Semantic search, vector store kullanımı, chunking ve attribute filtering mekanizmaları.
[6] Qdrant — "Hybrid Search" — erişim tarihi: 27 Eylül 2026
URL: https://qdrant.tech/documentation/search-tuning/hybrid-search/
Desteklediği iddialar: Dense ve sparse retrieval'ın farklı güçlü yönleri ile hybrid search yaklaşımı.
[7] pgvector — "Open-source vector similarity search for Postgres" — erişim tarihi: 27 Eylül 2026
URL: https://github.com/pgvector/pgvector
Desteklediği iddialar: Exact ve approximate nearest-neighbor search, HNSW ve IVFFlat indeksleri, filtering, recall/performance dengesi ve multitenancy seçenekleri.
[8] Qdrant — "Filtering" — erişim tarihi: 27 Eylül 2026
URL: https://qdrant.tech/documentation/search/filtering/
Desteklediği iddialar: Payload alanları üzerinden filtreleme, boolean filtre koşulları ve payload indexing.
[9] Kişisel Verileri Koruma Kurumu — "Yapay Zekâ Alanında Kişisel Verilerin Korunmasına Dair Tavsiyeler" — 2021 — erişim tarihi: 27 Eylül 2026
URL: https://kvkk.gov.tr/SharedFolderServer/CMSFiles/25a1162f-0e61-4a43-98d0-3e7d057ac31a.pdf
Desteklediği iddialar: Veri minimizasyonu, anonimleştirme, veri sorumlusu/veri işleyen rollerinin belirlenmesi ve yapay zekâ sistemlerinde mahremiyet yaklaşımı.
[10] Kişisel Verileri Koruma Kurumu — "Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi (15 Soruda)" — erişim tarihi: 27 Eylül 2026
URL: https://www.kvkk.gov.tr/Icerik/8547/uretken-yapay-zeka-ve-kisisel-verilerin-korunmasi-rehberi-15-soruda
Desteklediği iddialar: Üretken yapay zekâ sistemlerinde kişisel veri işleme faaliyetlerinin 6698 sayılı Kanun kapsamında değerlendirilmesi ve yaşam döngüsü boyunca veri koruma yaklaşımı.
[11] National Institute of Standards and Technology (NIST) — "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile", NIST AI 600-1 — Temmuz 2024 — erişim tarihi: 27 Eylül 2026
URL: https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf
Desteklediği iddialar: Üretken yapay zekâ risklerinin sistem yaşam döngüsü boyunca yönetişim, ölçüm ve risk yönetimi çerçevesinde ele alınması.
[12] Microsoft Learn — "Semantic ranking in Azure AI Search" — erişim tarihi: 27 Eylül 2026
URL: https://learn.microsoft.com/en-us/azure/search/semantic-search-overview
Desteklediği iddialar: İlk arama sonuçlarının ikincil bir anlamsal sıralama aşamasında yeniden puanlanması ve reranking yaklaşımı.