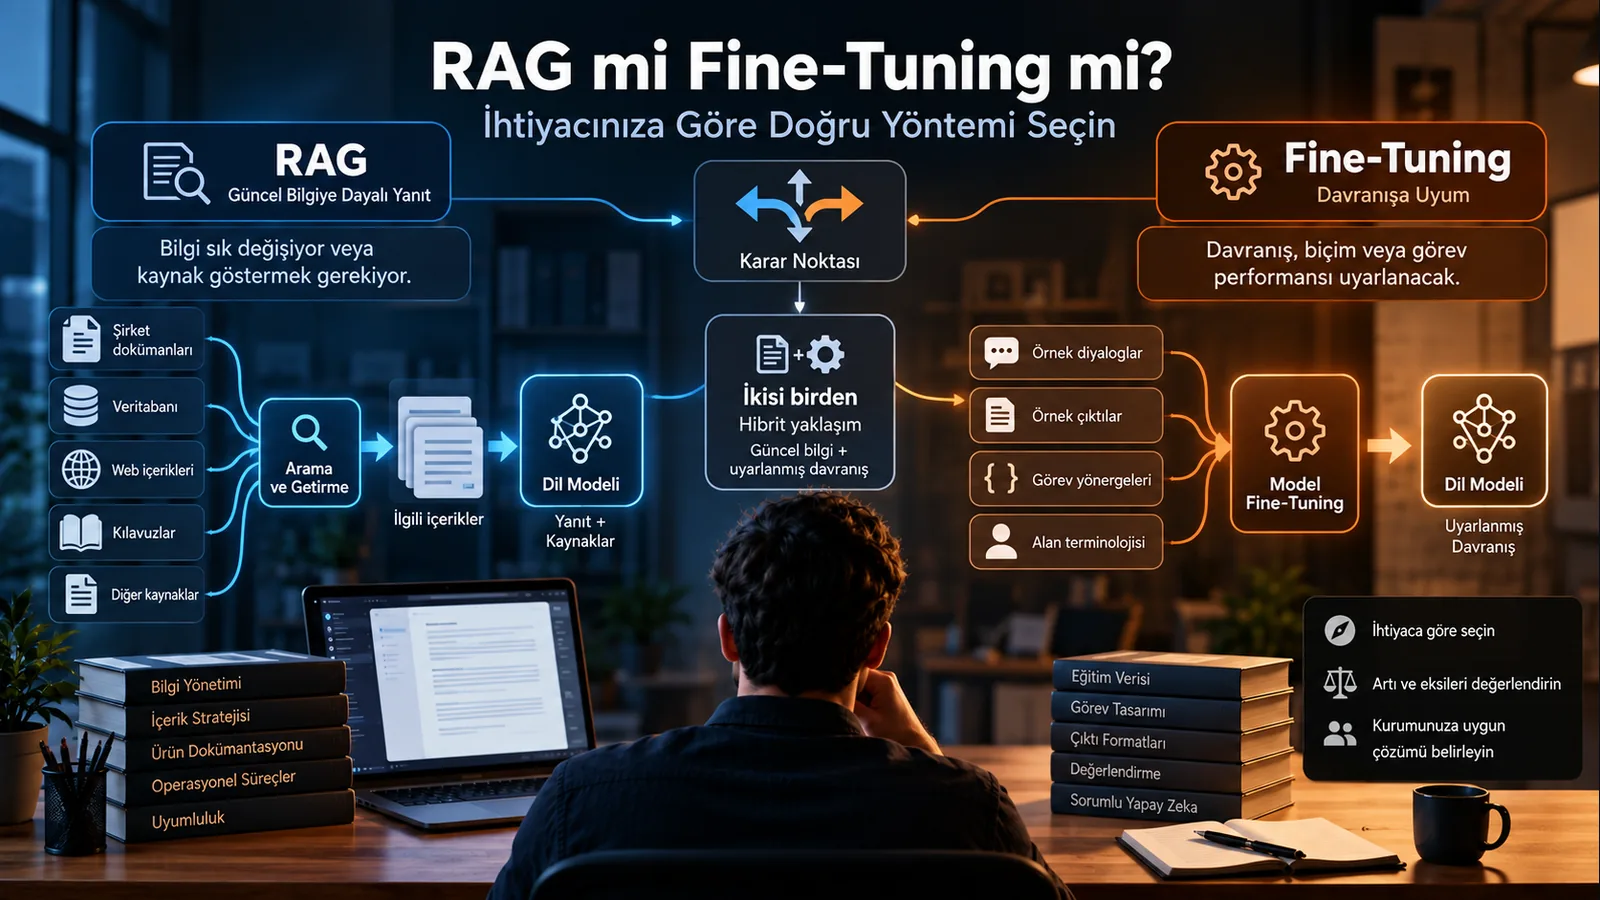
RAG ve Fine-Tuning Neden Sıklıkla Karıştırılıyor?
Bir şirket büyük dil modellerini kendi süreçlerine uyarlamak istediğinde genellikle aynı problemle karşılaşır: Genel amaçlı model şirketin ürünlerini, prosedürlerini, teknik dokümantasyonunu veya çalışma biçimini yeterince bilmiyordur.
Bu noktada iki kavram öne çıkar: Retrieval-Augmented Generation (RAG) ve Fine-Tuning.
İki yöntem de bir LLM tabanlı sistemin belirli bir kullanım alanında daha iyi sonuç vermesine yardımcı olabilir. Ancak bunu tamamen farklı mekanizmalarla gerçekleştirir.
En basit ayrım şöyledir:
RAG, modele ihtiyaç duyduğu bilgiyi çalışma anında getirir. Fine-Tuning ise modelin belirli örneklerden öğrenerek davranışını değiştirir.
RAG sisteminde şirket belgeleri genellikle model parametrelerinin içine yeniden öğretilmez. Kullanıcının sorusuyla ilişkili bilgiler bir bilgi kaynağından bulunur ve modelin bağlamına eklenir. Fine-Tuning'de ise önceden eğitilmiş model, seçilmiş eğitim örnekleri üzerinden ek bir eğitim sürecinden geçirilir.
Bu nedenle “şirket verilerimizi modele öğretmek istiyoruz” cümlesi tek başına Fine-Tuning yapılması gerektiği anlamına gelmez. Özellikle şirket politikaları, ürün katalogları, prosedürler veya sürekli değişen bilgiler söz konusuysa RAG çoğu durumda daha doğal bir başlangıç noktasıdır. Bu ayrım sağlayıcıdan bağımsızdır: güncel veya kuruma özgü bilgiye erişim gerekiyorsa retrieval; tekrarlanan görev davranışını örneklerle değiştirmek gerekiyorsa fine-tuning değerlendirilir [1].
RAG Nedir?
Retrieval-Augmented Generation, Türkçede genellikle getirme destekli üretim veya erişim destekli üretim olarak ifade edilir.
RAG yaklaşımının temel amacı, büyük dil modelinin yalnızca kendi parametrelerinde bulunan bilgiye güvenmesi yerine, yanıt oluştururken harici bilgi kaynaklarına erişmesini sağlamaktır.
RAG kavramının modern LLM bağlamındaki temel çalışmalarından biri Patrick Lewis ve çalışma arkadaşlarının 2020 tarihli “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” makalesidir [2]. Çalışma, parametrik model bilgisini harici ve parametrik olmayan bir bilgi kaynağıyla birleştiren yaklaşımı ele almıştır.
Kurumsal bir RAG sistemi basitleştirilmiş olarak şu şekilde çalışabilir:
- Şirket dokümanları sisteme aktarılır.
- Dokümanlar uygun parçalara, yani chunk'lara bölünür.
- İçerikler embedding modelleri kullanılarak sayısal gösterimlere dönüştürülebilir.
- Bu gösterimler bir vektör deposunda veya uygun arama altyapısında saklanır.
- Kullanıcı soru sorduğunda ilgili içerikler aranır.
- En alakalı bölümler LLM'in bağlamına eklenir.
- Model cevabını bu bilgilerden yararlanarak üretir.
OpenAI'nin güncel API altyapısında da dosyaların vector store yapısına eklenmesi, parçalara ayrılması ve file_search gibi araçlarla erişilebilir hâle getirilmesi desteklenmektedir [3].
Dolayısıyla RAG'ın temel problemi “modeli yeniden eğitmek” değil, doğru bilgiyi doğru anda modele ulaştırmaktır.
Fine-Tuning Nedir?
Fine-Tuning, önceden eğitilmiş bir modelin ağırlıklarının belirli örneklerden oluşan ek bir veri kümesiyle uyarlanmasıdır. Bu işlem belirli görevlerdeki performansı, çıktı biçimini ve model davranışını değiştirebilir.
Örneğin genel amaçlı bir modelden sürekli olarak belirli bir JSON şemasında çıktı almak, şirketin kullandığı özel sınıflandırma mantığını öğretmek veya belirli bir görevde tutarlı davranmasını sağlamak isteyebilirsiniz.
Bu durumda yüzlerce veya binlerce kaliteli giriş-çıkış örneği hazırlanabilir ve model bu örnekler üzerinden optimize edilebilir.
Fine-tuning desteği sağlayıcıya, modele ve tarihe göre değişir. OpenAI'nin resmî takvimine göre daha önce fine-tuning işi çalıştırmamış kuruluşların yeni iş oluşturması 7 Mayıs 2026'da; son 60 gün içinde fine-tuned bir modelle inference yapmamış kuruluşların yeni iş oluşturması 2 Temmuz 2026'da kapatıldı. Aktif mevcut müşteriler 6 Ocak 2027'den itibaren yeni fine-tuning işi oluşturamayacak; önceden özelleştirilmiş modeller ise ilgili temel model kullanımdan kaldırılana kadar inference için erişilebilir kalacak [4]. Buna karşılık bazı bulut sağlayıcıları ve açık ağırlıklı modeller farklı özelleştirme yolları sunmaya devam ediyor. Bu nedenle mimari karar, tek bir sağlayıcının geçici ürün kataloğuna bağlanmamalıdır.
Buradaki önemli nokta şudur:
Fine-Tuning bir veritabanı oluşturma yöntemi değildir.
Bir modele ürün kataloğunun tamamını Fine-Tuning ile vermek, modelin bu bilgileri gerektiğinde eksiksiz biçimde geri çağıracağı anlamına gelmez. Model eğitim sırasında örüntüler öğrenir; eğitim verisini sorgulanabilir bir kayıt sistemi gibi saklamaz.
Bu nedenle Fine-Tuning; belirli görevlerdeki performansı ve modelin nasıl davranacağını uyarlamak için kullanılabilir, ancak kurumsal gerçekleri eksiksiz ve güncel biçimde geri çağıran bir veritabanı değildir.
RAG ve Fine-Tuning Arasındaki Temel Farklar
| Kriter | RAG | Fine-Tuning |
|---|---|---|
| Temel amaç | Harici bilgiye erişim sağlamak | Model ağırlıklarını örneklerle uyarlayarak görev performansını ve davranışı değiştirmek |
| Bilginin konumu | Harici veri kaynağı | Model parametrelerine öğrenme yoluyla yansır |
| Güncel bilgi | Güçlü kullanım alanlarından biridir | Yeniden eğitim gerekebilir |
| Kaynak gösterme | Uygun mimariyle mümkündür | Doğrudan doğal bir özellik değildir |
| Veri değişim sıklığı | Sık değişen bilgiler için uygundur | Daha stabil örnekler tercih edilir |
| Eğitim veri seti | Zorunlu değildir | Kaliteli eğitim örnekleri gerekir |
| Retrieval altyapısı | Genellikle gerekir | Gerekmez |
| Model davranışını değiştirme | Sınırlı | Temel güçlü yönlerinden biridir |
| Kurumsal doküman arama | Genellikle uygun | Tek başına çoğu durumda uygun değildir |
| Belirli çıktı biçimini öğretme | Prompt ile yapılabilir | Tekrarlayan görevlerde güçlü olabilir |
| Güncelleme | Veri kaynağı güncellenebilir | Yeni Fine-Tuning süreci gerekebilir |
| Birlikte kullanılabilir mi? | Evet | Evet |
Bu tablo bir ürün karşılaştırması değil, problem türlerini ayıran bir tasarım çerçevesidir. Sunulan özellikler ve desteklenen modeller değişebileceği için uygulama kararı güncel sağlayıcı belgeleriyle ayrıca doğrulanmalıdır.
Karar Ağacı: Önce Hangi Soruyu Sorun?
Sorun güncel veya kuruma özgü bilgi eksikliği mi?
├─ Evet → Önce retrieval/RAG tabanı kur ve retrieval kalitesini ölç.
│  └─ Yanıt davranışı hâlâ tutarsız mı?
│     ├─ Evet → Yeterli örnek ve desteklenen model varsa fine-tuning'i ayrıca değerlendir.
│     └─ Hayır → RAG ile devam et.
└─ Hayır → Sorun biçim, sınıflandırma veya tekrarlanan görev davranışı mı?
   ├─ Evet → Önce prompt ve değerlendirme tabanı; sonra fine-tuning adayı.
   └─ Hayır → Klasik arama, kural tabanlı yazılım veya başka bir yöntem daha uygun olabilir.
Bu yaklaşım, genel bir RAG tanıtımından farklı olarak doğrudan seçim kararına odaklanır: önce hatanın bilgi erişiminden mi, davranıştan mı, yoksa yapay zekâ gerektirmeyen bir süreçten mi kaynaklandığı teşhis edilir.
Asıl Soru: Bilgiyi mi, Davranışı mı Değiştirmek İstiyorsunuz?
RAG ile Fine-Tuning arasındaki seçimde en kullanışlı sorulardan biri budur.
Bir müşteri destek asistanı düşünelim.
Şirket şunları bilmesini istiyor olabilir:
- Güncel ürün özellikleri
- Fiyatlandırma politikaları
- Garanti koşulları
- Kullanım kılavuzları
- Güncel kampanyalar
- Teknik dokümantasyon
Bu bilgiler zaman içinde değişiyorsa temel ihtiyaç bilgi erişimidir. Böyle bir problem RAG yaklaşımına daha yakındır.
Fakat şirket şunları istiyorsa:
- Her cevabı belirli bir formatta üretmek
- Talepleri şirketin özel kategorilerine ayırmak
- Belirli etiketleme kurallarını öğrenmek
- Sürekli aynı yapıda veri çıkarmak
- Belirli görevlerde daha tutarlı davranmak
problem artık daha fazla model davranışı ile ilgilidir. Yeterli kaliteli örnek varsa Fine-Tuning değerlendirilebilir.
Bu ayrım mutlak değildir. Modern kurumsal sistemlerde iki yaklaşım birlikte de kullanılabilir.
Hangi Durumlarda RAG Tercih Edilmeli?
Bilgiler sık değişiyorsa
Ürün fiyatları, stok bilgileri, prosedürler, teknik belgeler ve şirket politikaları sürekli değişebilir.
Bu bilgilerin her değişiminde modeli yeniden eğitmek operasyonel olarak verimsiz olabilir.
RAG sisteminde ise veri kaynağı güncellendiğinde yeni içerik retrieval katmanına aktarılabilir.
AWS, sık değişen özel dokümanların Fine-Tuning için uygun olmayabileceğini ve güncel veya kuruma özgü dokümanlardan cevap üretmek gereken durumlarda RAG'ın güçlü bir seçenek olduğunu belirtmektedir [1][6].
Kaynak göstermek gerekiyorsa
Bir şirket çalışanının:
“Bu prosedür hangi dokümana dayanıyor?”
sorusunun cevabını bilmesi gerekebilir.
RAG sistemlerinde getirilen doküman parçalarının metadata bilgileri korunarak cevabın dayandığı doküman, bölüm veya kaynak kullanıcıya gösterilebilir.
Bu özellik özellikle hukuk, finans, insan kaynakları, kalite yönetimi ve teknik destek gibi doğrulanabilirliğin önemli olduğu alanlarda değerlidir.
Ancak kaynak gösterilmesi cevabın otomatik olarak doğru olduğu anlamına gelmez. Retrieval sisteminin yanlış dokümanı getirmesi veya modelin doğru kaynağı yanlış yorumlaması hâlâ mümkündür.
Büyük bir kurumsal bilgi tabanı varsa
Binlerce prosedür, PDF, teknik doküman, sözleşme veya yardım merkezi makalesinin bulunduğu sistemlerde bilgilerin tamamını model parametrelerine aktarmaya çalışmak yerine sorgu sırasında ilgili bölümleri bulmak daha yönetilebilir olabilir.
Bilgi erişim izinleri önemliyse
İyi tasarlanmış bir RAG sisteminde retrieval katmanı kullanıcı yetkileriyle birlikte çalışabilir.
Örneğin finans departmanının erişebildiği belgelerle satış ekibinin erişebildiği belgeler farklı olabilir.
Ancak bu güvenlik modelinin uygulama katmanında gerçekten uygulanması gerekir. Vektör veritabanına belge yüklemek tek başına erişim kontrolü sağlamaz.
Hangi Durumlarda Fine-Tuning Tercih Edilmeli?
Model belirli bir görevi sürekli yapıyorsa
Örneğin gelen müşteri mesajlarının şirketin kendi sınıflandırma sistemine göre kategorize edilmesi gerekebilir:
- ödeme problemi
- kargo problemi
- iade talebi
- teknik hata
- üyelik problemi
Prompt engineering yeterli doğruluğu veya tutarlılığı sağlamıyorsa ve yeterli kaliteli örnek bulunuyorsa Fine-Tuning değerlendirilebilir.
Belirli çıktı davranışları gerekiyorsa
Modelin sürekli belirli formatta çıktı üretmesi istenebilir.
Örneğin:
Kategori:
Öncelik:
Departman:
Özet:
Önerilen İşlem:
Prompt engineering çoğu zaman ilk denenmesi gereken yöntemdir. Ancak yüksek hacimli ve dar kapsamlı görevlerde Fine-Tuning, modelin istenen davranışı daha tutarlı öğrenmesine yardımcı olabilir.
Kuruma özgü örüntüler varsa
Bazı görevlerde şirketin kullandığı terimler veya karar örüntüleri genel modellerin alışık olduğu verilerden farklı olabilir.
Google Cloud da Fine-Tuning'i önceden eğitilmiş bir modeli görev odaklı verilerle uzmanlaştırma süreci olarak tanımlamakta ve yöntemin görev türü ile mevcut veri kalitesine göre değerlendirilmesi gerektiğini belirtmektedir [7].
RAG Her Zaman Daha Ucuz mudur?
Hayır.
RAG'ın model eğitimi gerektirmemesi, sistemin ücretsiz veya operasyonel olarak basit olduğu anlamına gelmez.
Üretim seviyesinde bir RAG sistemi şu bileşenleri gerektirebilir:
- veri alma pipeline'ı,
- belge ayrıştırma,
- chunking,
- embedding üretimi,
- vektör veya arama altyapısı,
- metadata yönetimi,
- retrieval,
- reranking,
- erişim kontrolü,
- prompt/context yönetimi,
- gözlemlenebilirlik,
- değerlendirme altyapısı.
AWS de özel RAG mimarilerinin planlama, geliştirme, yayınlama ve işletme açısından önemli miktarda çalışma gerektirebildiğini belirtmektedir [6].
Ayrıca her sorguda modele ek bağlam gönderilmesi token tüketimini ve gecikmeyi artırabilir.
Dolayısıyla maliyet karşılaştırması yalnızca:
Fine-Tuning ücreti mi daha yüksek, embedding maliyeti mi?
şeklinde yapılmamalıdır.
Toplam sahip olma maliyeti değerlendirilmelidir.
Buna geliştirme, altyapı, veri hazırlama, değerlendirme, bakım, model çağrıları ve operasyon maliyetleri dahildir.
Fine-Tuning Her Zaman Daha Doğru Sonuç Verir mi?
Hayır.
Fine-Tuning sonucunun kalitesi büyük ölçüde eğitim verisinin kalitesine bağlıdır.
Yanlış, tutarsız veya düşük kaliteli örnekler modele verildiğinde model bu örüntüleri öğrenebilir. AWS de üretken yapay zekâ uygulamalarında eğitim verisinin alaka düzeyi ve kalitesinin model performansı açısından kritik olduğunu vurgulamaktadır [8].
Ayrıca Fine-Tuning bilgi doğruluğunu otomatik olarak garanti etmez.
Model hâlâ:
- yanlış bilgi üretebilir,
- eğitim örneklerini yanlış genelleyebilir,
- beklenmeyen girdilerde başarısız olabilir,
- güvenilir görünen fakat hatalı cevaplar oluşturabilir.
Bu nedenle Fine-Tuning sonrasında bağımsız değerlendirme veri setleriyle test yapılması gerekir.
RAG Sistemlerinde En Büyük Risk: Retrieval Kalitesi
RAG sistemlerinde çoğu ekip yalnızca LLM çıktısını ölçer. Oysa sistem iki farklı problemi aynı anda çözmektedir:
- Doğru bilgiyi bulmak.
- Bulunan bilgiden doğru cevap üretmek.
Yanlış doküman getirildiyse dünyanın en güçlü üretken modeli bile doğru cevabı oluşturamayabilir.
Bu nedenle RAG değerlendirmesinde en az iki katman ayrı izlenmelidir.
Retrieval metrikleri
Örneğin:
- doğru doküman ilk sonuçlar arasında mı?
- gerekli bilgi gerçekten getiriliyor mu?
- gereksiz dokümanlar ne sıklıkla geliyor?
- metadata filtreleri doğru çalışıyor mu?
Generation metrikleri
Ardından:
- cevap getirilen kaynakla uyumlu mu?
- model kaynağın dışına çıkıyor mu?
- kritik bilgileri atlıyor mu?
- kaynak gösterimleri doğru mu?
Bu ayrım, problemin modelden mi yoksa retrieval katmanından mı kaynaklandığını anlamayı kolaylaştırır.
RAG ve Fine-Tuning Birlikte Kullanılabilir mi?
Evet.
Hatta bazı kurumsal kullanım senaryolarında en uygun mimari bu olabilir.
Örneğin bir şirket müşteri destek sistemi geliştiriyor olsun.
RAG:
- güncel ürün belgelerini,
- garanti koşullarını,
- teknik kılavuzları,
- şirket politikalarını
getirebilir.
Fine-Tuning uygulanmış model ise:
- talepleri şirket kategorilerine ayırabilir,
- istenen çıktı biçimini takip edebilir,
- destek sürecine özgü davranışları daha tutarlı uygulayabilir.
Bu durumda RAG bilgi katmanını, Fine-Tuning ise davranış katmanını özelleştirir.
AWS de bu tekniklerin birbirini dışlamak zorunda olmadığını ve daha gelişmiş sistemlerde birden fazla yaklaşımın birlikte kullanılabileceğini açıkça belirtmektedir [1].
Önce Prompt Engineering Denenmeli mi?
Çoğu projede evet.
Doğrudan Fine-Tuning'e veya karmaşık bir RAG mimarisine geçmeden önce temel modelin iyi tasarlanmış promptlarla ne kadar başarılı olduğu ölçülmelidir.
Pratik sıra çoğu projede şöyle olabilir:
Temel model → Prompt Engineering → RAG → Fine-Tuning → Gerekiyorsa hibrit mimari
Bu evrensel bir zorunluluk değildir. Ancak gereksiz teknik karmaşıklığı azaltmak açısından güçlü bir başlangıç prensibidir. AWS'nin güncel PoC rehberi de çoğu senaryoda önce prompt engineering ile başlanmasını, kurumsal veya güncel bilgi gerekiyorsa RAG eklenmesini ve Fine-Tuning'in belirli davranış veya dar görev gereksinimleri olduğunda değerlendirilmesini önerir [1].
Veri Güvenliği ve Gizlilik Açısından Nelere Dikkat Edilmeli?
RAG veya Fine-Tuning seçimi yalnızca performans kararı değildir.
Her iki yöntemde de şirket verisinin nerede işlendiği belirlenmelidir.
RAG sisteminde şu bileşenler veri görebilir:
- belge işleme servisi,
- embedding modeli,
- vektör veritabanı,
- retrieval servisi,
- LLM sağlayıcısı,
- loglama ve gözlemleme sistemleri.
Fine-Tuning sürecinde ise eğitim veri setinin hazırlanması, yüklenmesi, işlenmesi ve saklanması ayrıca değerlendirilmelidir.
Türkiye'de kişisel veri işleyen yapay zekâ uygulamalarının 6698 sayılı Kişisel Verilerin Korunması Kanunu kapsamındaki yükümlülüklerle birlikte değerlendirilmesi gerekir. KVKK'nın üretken yapay zekâ rehberi de yapay zekâ sistemlerinin yaşam döngüsü boyunca kişisel veri işleme faaliyetlerinin veri koruma ilkeleri açısından ele alınması gerektiğini vurgulamaktadır [9].
Bu nedenle mimari seçimden önce en az şu sorular cevaplanmalıdır:
- Sisteme kişisel veri girecek mi?
- Özel nitelikli kişisel veri bulunuyor mu?
- Veriler hangi ülkede işleniyor?
- Hangi servis sağlayıcılar veriye erişiyor?
- Veriler ne kadar süre tutuluyor?
- Loglarda kullanıcı girdileri saklanıyor mu?
- Kullanıcıların erişim yetkileri retrieval katmanında uygulanıyor mu?
- Eğitim veri setinde kişisel veya gizli bilgi bulunuyor mu?
- Veri silme süreçleri nasıl uygulanıyor?
Avrupa Birliği'nde faaliyet gösteren veya AI Act kapsamına giren kuruluşlar açısından sistemin kullanım senaryosuna bağlı ek yükümlülükler de gündeme gelebilir. AB Yapay Zekâ Tüzüğü, özellikle yüksek riskli AI sistemleri bakımından eğitim, doğrulama ve test veri setleri için veri yönetişimi ve yönetimi gereklilikleri tanımlar [10].
Temsili Kurumsal Senaryo
Aşağıdaki örnek gerçek bir şirket veya proje değildir; yalnızca yöntem seçimini göstermek amacıyla hazırlanmış temsili bir senaryodur.
Bir üretim şirketinin 8.000 teknik dokümanı bulunduğunu düşünelim.
Şirket çalışanları yapay zekâ sistemine şu tür sorular sormak istiyor:
X makinesinde E42 hatası oluştuğunda hangi bakım prosedürü uygulanmalı?
Dokümanlar düzenli olarak güncelleniyor.
Bu problemde ilk seçenek Fine-Tuning olmamalıdır. Çünkü asıl ihtiyaç model davranışını değiştirmek değil, güncel teknik dokümana erişmektir.
RAG mimarisi kurulabilir.
Kullanıcı sorusu geldiğinde sistem ilgili makine modeli, hata kodu ve prosedür dokümanlarını arar. İlgili bölümler modele gönderilir ve cevap kaynaklarıyla birlikte oluşturulur.
Bir süre sonra şirket başka bir ihtiyaç belirler.
Sistem her bakım talebini şu formatta sınıflandırmalıdır:
Makine:
Arıza Tipi:
Risk Seviyesi:
İlgili Departman:
Önerilen İş Akışı:
Prompt engineering ile yeterli tutarlılık sağlanamıyor ve şirketin geçmiş kayıtlarından kaliteli etiketlenmiş örnekler bulunuyorsa bu dar görev için Fine-Tuning ayrıca değerlendirilebilir.
Son mimari böylece:
RAG + Fine-Tuned Model
şeklinde olabilir.
RAG güncel teknik bilgiyi sağlar; Fine-Tuning ise belirli görev davranışını standartlaştırmaya yardımcı olur.
RAG Projesine Başlamak İçin Gerekli Roller
Her şirketin organizasyon yapısı farklıdır; ancak üretim seviyesindeki bir RAG projesinde genellikle şu sorumlulukların karşılanması gerekir:
- iş alanı uzmanlığı,
- veri mühendisliği,
- yazılım geliştirme,
- LLM / AI geliştirme,
- güvenlik,
- hukuk ve veri koruma,
- ürün sahipliği,
- kalite ve değerlendirme.
Bu rollerin her biri ayrı bir kişi olmak zorunda değildir. Küçük ekiplerde bir kişi birden fazla sorumluluk üstlenebilir.
Kritik olan sorumlulukların sahipsiz kalmamasıdır.
Pilot Proje Nasıl Tasarlanmalı?
RAG veya Fine-Tuning seçmeden önce küçük ve ölçülebilir bir pilot oluşturmak daha sağlıklı sonuç verir.
1. Tek kullanım senaryosu seçin
“Şirket için yapay zekâ asistanı yapacağız” çok geniş bir hedeftir.
Bunun yerine:
Teknik destek ekibinin ürün dokümanlarından cevap bulmasını sağlayacağız.
gibi sınırlandırılmış bir problem tanımlayın.
2. Değerlendirme veri seti oluşturun
Gerçek kullanım senaryolarını temsil eden soru veya görevlerden oluşan bir test seti hazırlayın.
Beklenen cevapları veya başarı kriterlerini önceden belirleyin.
3. Baseline ölçün
Önce temel modeli test edin.
Ardından:
- prompt engineering,
- RAG,
- gerekiyorsa Fine-Tuning
sonuçlarını aynı değerlendirme setinde karşılaştırın.
4. Hata kategorileri oluşturun
Sadece tek bir “başarı oranı” takip etmek yerine hataları sınıflandırın.
Örneğin:
- bilgi bulunamadı,
- yanlış doküman getirildi,
- doğru kaynak yanlış yorumlandı,
- format hatası,
- talimat ihlali,
- kaynaksız bilgi üretildi.
Bu yaklaşım hangi teknik müdahalenin gerekli olduğunu daha açık gösterir.
Başarı Nasıl Ölçülmeli?
Başarı kriterleri kullanım senaryosuna göre değişmelidir.
Kurumsal bilgi asistanında şu göstergeler değerlendirilebilir:
- doğru kaynağın bulunma oranı,
- cevapların kaynakla uyumu,
- cevapsız bırakılması gereken soruların doğru tespiti,
- kullanıcı geri bildirimi,
- cevap gecikmesi,
- sorgu başına maliyet.
Sınıflandırma sisteminde ise:
- precision,
- recall,
- F1,
- kategori bazında hata dağılımı
gibi ölçütler daha anlamlı olabilir.
Üretken yapay zekâ sistemlerinde yalnızca model doğruluğunu değil, riskleri de değerlendirmek gerekir. NIST'in Generative AI Profile dokümanı, üretken yapay zekâ sistemlerinde risklerin yaşam döngüsü boyunca yönetilmesini ve değerlendirme, doğrulama ve izleme süreçlerinin sistematik biçimde ele alınmasını önerir [11].
Sık Yapılan Hatalar
“Şirket verisini modele öğretelim” diyerek doğrudan Fine-Tuning yapmak
Kurumsal dokümanların modele verilmesi, bu bilgilerin güvenilir biçimde sorgulanabilir hâle geleceği anlamına gelmez.
Bilgi erişimi gerekiyorsa önce RAG değerlendirilmelidir.
RAG kurup retrieval kalitesini ölçmemek
Modelin yanlış cevap verdiği düşünülürken gerçek problem arama katmanı olabilir.
Retrieval ve generation ayrı değerlendirilmelidir.
Gereksiz yere büyük RAG altyapısı kurmak
Birkaç küçük doküman için karmaşık bir vektör arama sistemi her zaman gerekli değildir. Uzun bağlam destekleyen modellerde dokümanların doğrudan context içinde kullanılması bazı dar senaryolarda yeterli olabilir.
Fine-Tuning verisinin kalitesini önemsememek
Binlerce kötü örnek, yüzlerce iyi örnekten daha değerli değildir.
Eğitim verileri doğru, tutarlı ve hedef kullanım senaryosunu temsil eder nitelikte olmalıdır.
Güvenliği sonradan düşünmek
Özellikle kurumsal RAG sistemlerinde kullanıcıların erişmemesi gereken belgelerin retrieval sonucuna girmesi ciddi veri sızıntılarına neden olabilir.
Yetkilendirme, veri sınıflandırması ve erişim kontrolü mimarinin başından itibaren tasarlanmalıdır.
RAG mı Fine-Tuning mi? Karar Kontrol Listesi
Aşağıdaki sorular karar sürecini somutlaştırabilir:
- Sistemin kullanacağı bilgiler sık değişiyor mu?
- Cevapların hangi dokümana dayandığını göstermek gerekiyor mu?
- Binlerce kurumsal doküman arasında arama yapılacak mı?
- Kullanıcıların belge erişim yetkileri birbirinden farklı mı?
- Problem bilgi eksikliğinden mi kaynaklanıyor?
- Modelin davranışını değiştirmek mi gerekiyor?
- Tekrarlanan göreve ait yeterli ve kaliteli eğitim örnekleri var mı?
- Prompt engineering ile hedef performansa ulaşılamadığı ölçüldü mü?
- Fine-Tuning sonrası bağımsız değerlendirme veri seti hazır mı?
- RAG kullanılacaksa retrieval performansı ayrıca ölçülebiliyor mu?
- Kişisel ve gizli verilerin hangi sistemlerden geçtiği biliniyor mu?
- Veri saklama ve erişim politikaları tanımlandı mı?
- Model ve altyapı maliyetleri birlikte hesaplandı mı?
- İnsan denetiminin gerekli olduğu karar noktaları belirlendi mi?
- Pilot başarısız olduğunda projeyi durduracak kriterler önceden tanımlandı mı?
Soruların çoğu bilgi erişimi, güncellik ve kaynak doğrulamasıyla ilgiliyse RAG daha güçlü adaydır.
Soruların çoğu davranış, format veya dar görev performansıyla ilgiliyse Fine-Tuning değerlendirilmelidir.
Her iki ihtiyaç aynı anda bulunuyorsa hibrit mimari düşünülmelidir.
Hangi Durumlarda İkisini de Kullanmayabilirsiniz?
RAG ve Fine-Tuning popüler olduğu için her LLM projesinde gerekli değildir.
Şu durumda yalnızca güçlü bir temel model ve iyi tasarlanmış prompt yeterli olabilir:
- görev genel bilgi gerektiriyorsa,
- harici kurumsal bilgi gerekmiyorsa,
- çıktı davranışı prompt ile yeterince kontrol edilebiliyorsa,
- kullanım hacmi düşükse,
- mevcut performans iş ihtiyacını karşılıyorsa.
Teknik mimariye yeni bileşen eklemek yalnızca doğrulanmış bir problemi çözdüğünde anlamlıdır.
Sonuç
RAG ve Fine-Tuning aynı problemi çözen iki rakip teknoloji değildir.
RAG, modelin ihtiyaç duyduğu harici bilgiye erişmesini sağlar. Fine-Tuning ise modelin belirli örneklerden öğrenerek belirli görevlerde veya davranışlarda uzmanlaşmasına yardımcı olur.
Şirket içi dokümanlar, güncel bilgiler ve kaynak gösterme ihtiyacı ön plandaysa RAG genellikle daha doğal bir başlangıç noktasıdır. Belirli görev davranışları, sınıflandırma mantıkları veya tutarlı çıktı biçimleri öğrenilecekse Fine-Tuning değerlendirilebilir.
Bazı sistemlerde iki yaklaşım birlikte kullanılabilir. Bazılarında ise ikisine de ihtiyaç olmayabilir.
Bu nedenle doğru soru yalnızca “RAG mı Fine-Tuning mi?” değildir.
Daha doğru soru şudur:
Sistemde çözmeye çalıştığımız problem bilgiye erişim problemi mi, model davranışı problemi mi, yoksa ikisinin birleşimi mi?
Sık Sorulan Sorular
RAG mı Fine-Tuning mi daha iyi?
Tek başına daha iyi bir yöntem yoktur. RAG özellikle güncel veya kurumsal bilgiye erişim için uygundur. Fine-Tuning ise belirli görev davranışlarını veya çıktı örüntülerini modele öğretmek için kullanılabilir.
Şirket dokümanlarını Fine-Tuning ile modele öğretmek mantıklı mı?
Dokümanların amacı güncel bilgi tabanı oluşturmaksa çoğu durumda önce RAG değerlendirilmelidir. Fine-Tuning dokümanları sorgulanabilir bir veritabanına dönüştürmez.
RAG için vektör veritabanı şart mı?
Hayır. RAG genel olarak harici bilgiyi bulup modele sağlama yaklaşımıdır. Vektör arama yaygın bir yöntemdir ancak klasik arama, hibrit arama, SQL sorguları, grafik veritabanları veya başka retrieval mekanizmaları da kullanılabilir.
Fine-Tuning halüsinasyonu tamamen engeller mi?
Hayır. Fine-Tuning sonrasında da model hatalı veya uydurma bilgiler üretebilir. Sistem bağımsız değerlendirme verileriyle test edilmeli ve kritik kullanım alanlarında gerekli kontroller uygulanmalıdır.
RAG halüsinasyonu engeller mi?
RAG, modele ilgili kaynakları sağlayarak kaynaksız üretimi azaltmaya yardımcı olabilir ancak tamamen ortadan kaldırmaz. Retrieval hataları ve modelin getirilen kaynağı yanlış yorumlaması mümkündür.
RAG ve Fine-Tuning aynı anda kullanılabilir mi?
Evet. RAG güncel bilgi sağlayabilirken Fine-Tuning modelin belirli görevlerdeki davranışını özelleştirebilir.
Fine-Tuning yapmadan önce ne yapılmalı?
Öncelikle temel modelin ve prompt engineering yaklaşımının performansı ölçülmelidir. Problem bilgi eksikliğiyse RAG denenebilir. Fine-Tuning ise mevcut yöntemlerin neden yetersiz kaldığı ölçüldükten sonra değerlendirilmelidir.
RAG sistemi kurmak pahalı mı?
Maliyet mimariye bağlıdır. Embedding, arama altyapısı, model çağrıları, veri işleme, yazılım geliştirme ve bakım birlikte değerlendirilmelidir. Bu nedenle yalnızca API fiyatlarına bakılarak karar verilmemelidir.
RAG için şirket verilerinin buluta gönderilmesi gerekir mi?
Zorunlu değildir. Mimari kullanılan servis ve altyapıya bağlıdır. Bulut, özel bulut veya kurum içi bileşenlerden oluşan farklı mimariler kurulabilir. Önemli olan verinin hangi bileşenlerde işlendiğinin ve kimlerin erişebildiğinin açık biçimde belirlenmesidir.
Kaynaklar
[1] Amazon Web Services — AWS Prescriptive Guidance, “Architecting a successful generative AI proof of concept.”
- Güncellik: Erişim tarihinde aktif dokümantasyon
- URL: AWS Prescriptive Guidance – Choosing an AI approach
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Prompt engineering, RAG ve Fine-Tuning arasında kullanım senaryosuna göre seçim yapılması; güncel/kurumsal bilgi için RAG, belirli davranış ve dar görevler için Fine-Tuning yaklaşımı.
[2] Patrick Lewis ve diğerleri — “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.”
- Yayın tarihi: 22 Mayıs 2020
- URL: RAG araştırması – arXiv
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Parametrik model belleğinin harici, parametrik olmayan bilgi kaynaklarıyla birleştirilmesine dayanan RAG yaklaşımının akademik temeli.
[3] OpenAI — “Vector store files / File Search.”
- Güncellik: Erişim tarihinde aktif API dokümantasyonu
- URL: OpenAI Vector Store Files dokümantasyonu
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Dosyaların vector store yapısına eklenmesi, chunking stratejileri ve File Search gibi retrieval mekanizmalarında kullanılabilmesi.
[4] OpenAI — “API deprecations” ve “Model optimization.”
- Güncellik: 27 Eylül 2026 itibarıyla resmî dokümantasyon
- URL: OpenAI API deprecations — fine-tuning takvimi ve OpenAI model optimizasyonu
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Fine-tuning erişiminin kuruluş geçmişine göre kapatılma tarihleri, aktif mevcut müşteriler için 6 Ocak 2027 takvimi, mevcut özelleştirilmiş modellerin temel model kullanımdan kalkana kadar inference için kalması ve model optimizasyonu yaklaşımı.
[5] Microsoft — “Büyük dil modellerini alma destekli oluşturma veya ince ayar ile geliştirme.”
- Son güncelleme: 30 Ocak 2026
- URL: Microsoft Learn – Retrieval augmented generation and indexes
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Dinamik ve güncel bilgi için RAG; belirli görev performansı ve stabil içerik için Fine-Tuning ayrımı.
[6] Amazon Web Services — “Retrieval Augmented Generation options and architectures on AWS.”
- Güncellik: Erişim tarihinde aktif AWS Prescriptive Guidance
- URL: AWS – RAG options and architectures
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: RAG ve Fine-Tuning avantajları, sınırlamaları; sık değişen belgelerde Fine-Tuning'in dezavantajları ve üretim seviyesinde RAG mimarisinin operasyonel gereksinimleri.
[7] Google Cloud — “Fine-tuning LLMs and AI models.”
- Güncellik: Erişim tarihinde aktif Google Cloud dokümantasyonu
- URL: Google Cloud – Fine-Tuning LLMs
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Fine-Tuning'in önceden eğitilmiş modelleri görev odaklı veri setleriyle belirli kullanım alanlarına uyarlama yöntemi olması ve RAG/Fine-Tuning seçiminin kullanım senaryosuna bağlı olması.
[8] Amazon Web Services — “Choosing a generative AI service – AWS Decision Guide.”
- Güncellik: Erişim tarihinde aktif karar rehberi
- URL: AWS Generative AI Decision Guide
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Fine-Tuning süreçlerinde eğitim verisinin alaka düzeyi ve kalitesinin model performansı açısından kritik olması.
[9] Kişisel Verileri Koruma Kurumu — “Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi (15 Soruda).”
- Güncellik: Erişim tarihinde KVKK'nın aktif resmî rehberi
- URL: KVKK – Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Üretken yapay zekâ sistemlerinin yaşam döngüsü boyunca kişisel veri işleme faaliyetlerinin 6698 sayılı Kanun ve veri koruma ilkeleri açısından değerlendirilmesi gerekliliği.
[10] Avrupa Parlamentosu ve Avrupa Birliği Konseyi — Regulation (EU) 2024/1689, Artificial Intelligence Act; 27 Temmuz 2026 tarihli konsolide metin.
- Kabul tarihi: 13 Haziran 2024
- Resmî Gazete: 12 Temmuz 2024
- URL: EUR-Lex – güncel konsolide AI Act
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Özellikle yüksek riskli AI sistemlerinde eğitim, doğrulama ve test veri setlerine ilişkin veri yönetişimi ve yönetimi gereklilikleri.
[11] National Institute of Standards and Technology — “Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1).”
- Yayın tarihi: 26 Temmuz 2024; NIST sayfası 8 Nisan 2026'da güncellenmiştir
- URL: NIST AI 600-1 – Generative AI Profile
- Erişim tarihi: 27 Eylül 2026
- Desteklediği iddia: Üretken yapay zekâ risklerinin sistem yaşam döngüsü boyunca yönetişim, ölçüm ve risk yönetimi süreçleriyle ele alınması gerekliliği.